1. 解封装与解码
Mediabunny 读取容器,浏览器自带的 VideoDecoder 把视频流解码成帧。帧通过有上限的队列逐批处理。
1080p 拉到 4K 用的是卷积重采样,不是生成式模型,不会凭空补出原来没有的细节。 处理在浏览器里进行,不上传。
1080p 拉到 4K 用的是卷积重采样,不是生成式模型,不会凭空补出原来没有的细节。处理在浏览器里进行,不上传。
把视频拖到这里开始放大
支持 MP4、MOV、WebM、MKV。文件在本机读取,不会上传。
画质预设会同时设定插值算法和边缘对比。在这里改动任意一项,就会改为自定义设置。
处理完成前请保持此标签页打开。关闭或刷新页面会中止任务。
这个流程在当前浏览器标签页处理文件。可选用开发者工具观察页面实际发出的请求。
Network 里常见:本站 CSS/JS;开始处理后还有同源 WASM、编码器或 OCR 语言包。那是下载引擎,不是上传你的文件。
这是产品事实说明,不是实时抓包。我们不会伪造请求计数。广告、扩展和你之后的点击仍可能产生网络请求。
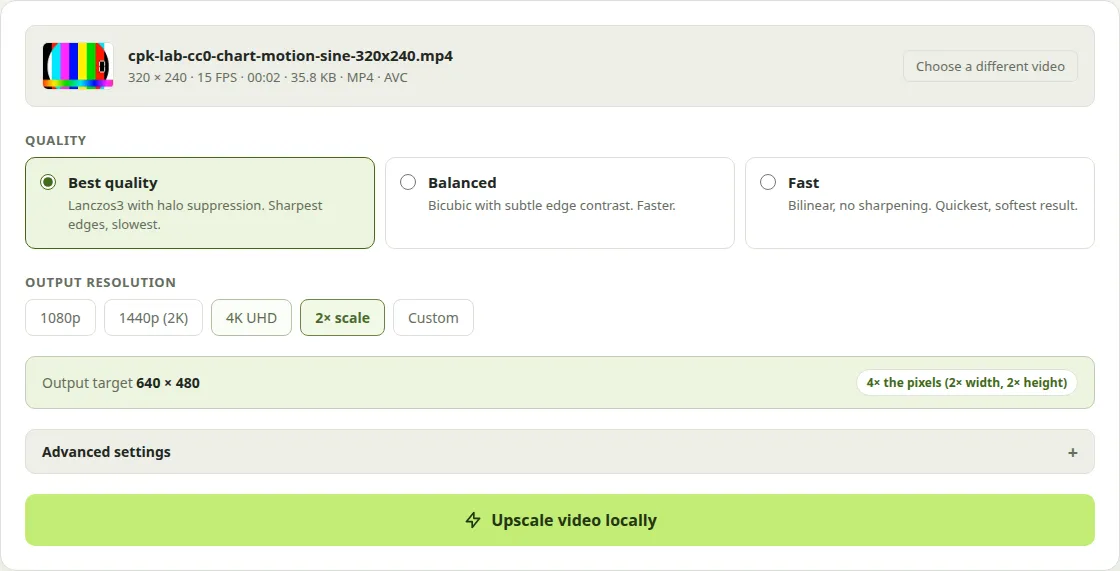
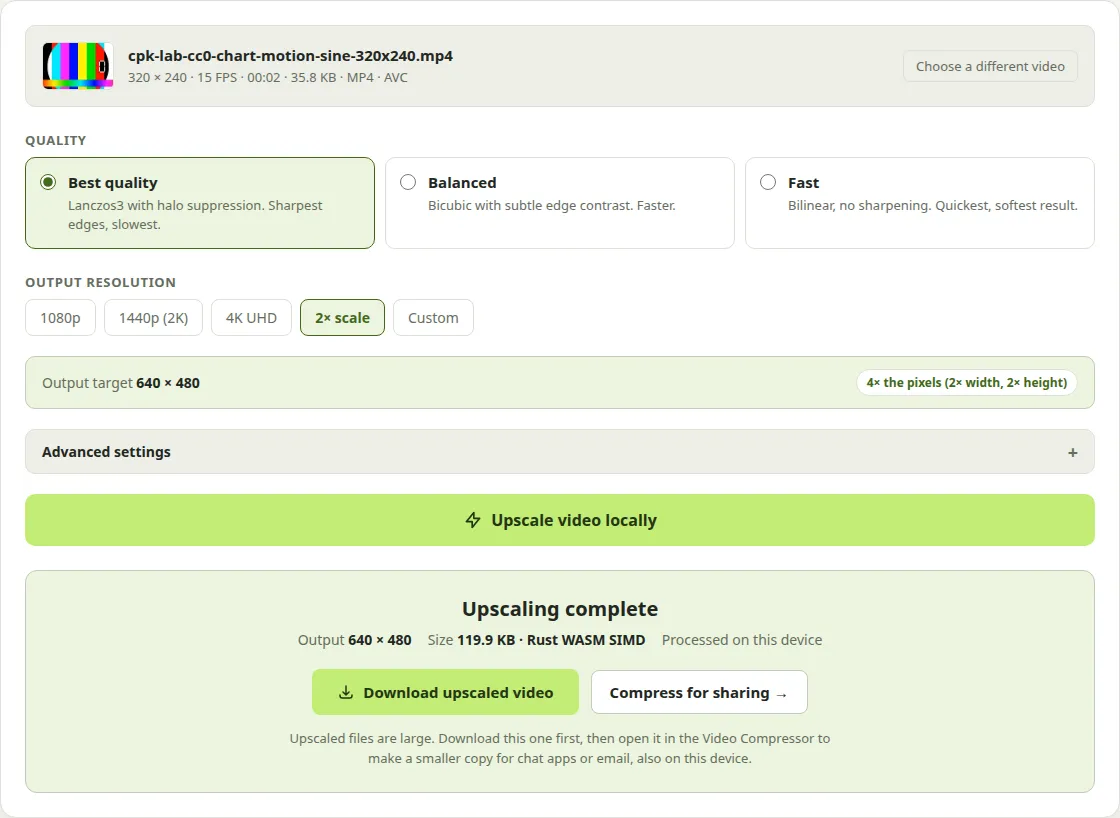
的浏览器实测只展示这一条受控样本。样本 upscaling-lab-chart-sine-lanczos3-2x 是 CC0 实验室色卡视频,不是真实拍摄,上传名为 cpk-lab-cc0-chart-motion-sine-320x240.mp4。 这两张图是采集时英文页面的界面截图,不是本页现在的中文界面。
流程状态是通过。输入界面是设置可见,输出界面是结果可见。选项是 2 倍、Lanczos3、锐化关闭。画面从 320×240 变成 640×480。像素数变多,这是数学重采样,不会恢复原来没有的细节。
这次输出 122742 字节,输入 36625 字节,文件更大。放大用的是卷积,不是生成式模型。这里只放设置和结果两张界面图。
整个流程都在这个标签页里完成,只用到浏览器标准 API 和一个小型 WebAssembly 模块。没有服务器排队,也没有生成式模型。
Mediabunny 读取容器,浏览器自带的 VideoDecoder 把视频流解码成帧。帧通过有上限的队列逐批处理。
每一帧交给由 Rust 编译的 WebAssembly 模块处理,浏览器支持时启用 SIMD。模块按你选择的算法放大画面;Lanczos3 会在边缘附近限制数值,减少光晕伪影。
VideoEncoder 压缩放大后的帧,再由 Mediabunny 写入输出文件。兼容的音频尽量直接复制,不重新编码;默认不写入标准容器元数据标签。
生成式放大工具可能加入原片里从未拍到的细节,比如新的皮肤纹理、发丝或文字。重采样只在已有像素之间插值。画面会比 AI 放大柔和一些,但不会凭空添加内容,这对证据素材、纪录片和存档母版很重要。
不会。解码、Lanczos3 重采样、编码和混流都在你的浏览器里完成。第一次开始放大时,页面会从本站下载处理引擎(一个小型 WebAssembly 文件和一个 worker 脚本);之后没有任何请求会携带你的视频。你可以在浏览器开发者工具的“网络”面板里自己核对。
不会。该工具使用确定性数学卷积核(Lanczos3、双三次 Bicubic 和双线性 Bilinear 算法)。与生成式 AI 或扩散模型不同,它绝不会凭空捏造新的人脸、修改物体轮廓或虚构纹理。
处理流程在支持的浏览器中使用 OPFS(源私有文件系统)磁盘流式写入;在不支持 OPFS 流式写入的环境下自动使用内存回退。视频逐帧解码并重采样,使内存保持在受控范围内。
兼容的音轨会尽可能直接复制而不重新编码。如果所选输出容器无法承载源音频格式,浏览器可能会进行转码以保持播放兼容性。
默认情况下不会复制输出元数据标签。这会移除输出混流器管理的标准容器元数据标签,生成更干净的分享文件。
当前版本主要针对 SDR 视频。重采样核心使用 8 位 RGBA 像素处理,因此暂不保证 HDR 或 10 位广色域元数据的完整保留。
不能。它不会做面部幻觉或扩散生成。边缘可以轻微锐化,但新像素来自周围像素的计算。